如果一个程序只是想知道“这张工单应该交给哪个部门”,它真的需要大语言模型(LLM)先写一段分析、消耗成百上千个 Token,再由后端代码从生成的文字中提取答案吗?
针对这一工程痛点,由前 OpenAI 研究员 Diogo Almeida 创立的 TypeSafe AI 带来了一种截然不同的解法——推出面向结构化决策的 System One 模型 Jev:让 AI 深度理解语义,但不让它自由发挥,直接返回预定义的选项、评分与概率分布,供后端业务系统直接执行。
2026 年 9 月 15 日,TypeSafe AI 宣布完成由 DCVC 领投的 4000 万美元种子轮融资,并正式开放 Jev 的早期访问(同时已集成至 Vercel AI Gateway)。与面向普通用户的对话助手不同,Jev 的首要目标客户是软件本身:它不负责聊天,也不负责写代码,而是旨在成为开发者可以嵌入业务流程中的一个高频“语义判断组件”。
理解 Jev 的关键,不是把它看作“更便宜、缩水的聊天模型”,而是理解它为什么从底层架构上主动放弃了自由对话与文本生成。
软件需要的,往往不是一段回答
设想一套客服自动化系统收到这样一条用户消息:
“昨天同一笔订单被扣了两次钱,到现在也没有退回来,麻烦尽快处理。”
在业务逻辑层面,系统接下来需要确定的其实只有几个核心问题:
- 分类归属:这属于账单问题还是技术故障?
- 意图判断:客户是否在明确申请退款?
- 紧急程度:是否需要提高处理优先级?
处理这些问题确实需要理解自然语言,但答案本身并不开放。软件往往不需要一封措辞得体的客套回信,也不需要长篇大论的因果剖析;它真正需要的是能直接用于业务分流、分支跳转和数据库更新的结构化数据。
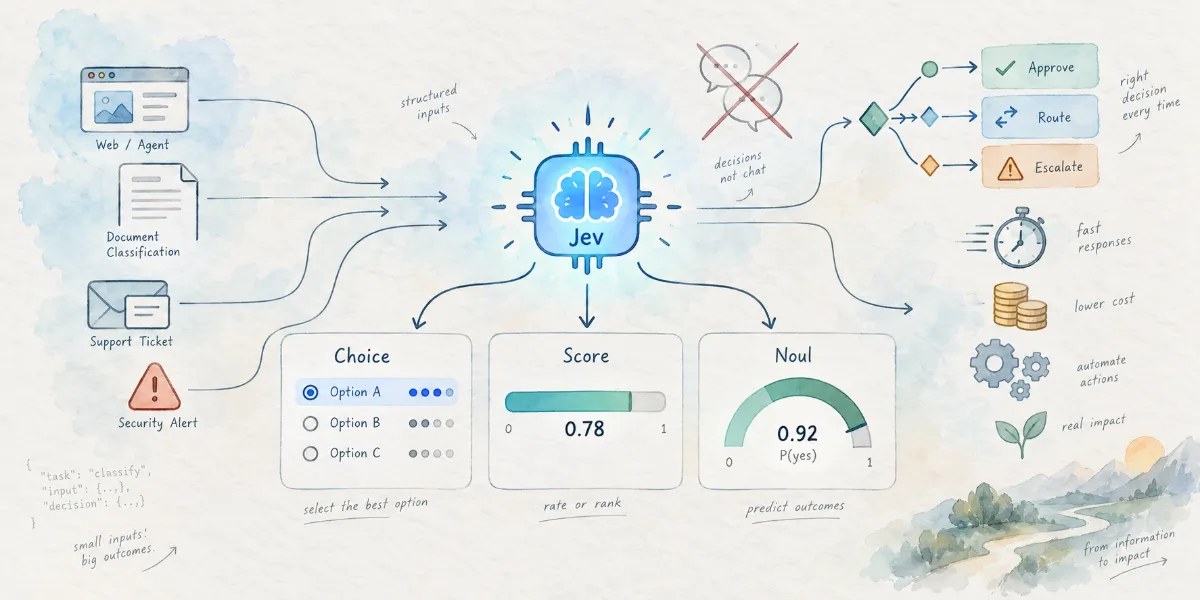
Jev 正是为这种场景量身定制。开发者向模型传入当前状态(如客户消息、订单记录和业务规则),并严格限定允许的问题与备选答案。模型直接返回受约束的结构化结果,而不是发散生成的自然语言。
System One Model(系统一模型):其命名灵感源自认知心理学名著《思考,快与慢》中人类快速、直觉式的“系统 1”判断。这里强调的是快速、低延迟、高度聚焦的决策任务,而非指模型复刻了人脑结构,更不代表它适合解决所有需要深度推理的复杂问题。
一个直观的类比是:通用聊天模型就像一个可以交流的顾问助手,而 Jev 更像一个嵌入在代码内部、能够读懂语义的判断函数。
三种输出,覆盖三类核心判断
Jev 的 API 接口围绕三种基础类型展开:Choice、Score 与 Noul。开发者无需写冗长的 Prompt 笼统要求“帮我分析一下”,而是以强类型的方式明确告诉模型程序需要哪一种数据结构:
| 类型 | 解决的问题 | 核心机制 | 典型示例 |
|---|---|---|---|
| Choice | 单项选择题 | 从预设选项(最多 255 项)中选一,返回选项分布与置信度 | 这张工单应交给账单、技术还是销售部门? |
| Score | 标尺评分题 | 依据预设的有序评价阶梯打分,返回加权后的连续数值(支持小数) | 系统故障是轻微影响、存在替代方案,还是完全阻断业务? |
| Noul | 概率真值题 | 针对陈述判断为真的概率(0~1 浮点数),直接反映倾向程度 | 客户是否在消息中明确提出了退款诉求? |
1. Choice(单项选择)
Choice 适用于分类与路由。它会返回被选中的选项、各个选项的完整概率分布以及一个整体置信度(Confidence)指标。目前单个 Choice 最多支持 255 个选项。由于所有选项必须由开发者事先严格枚举,模型无法凭空创造一个不存在的部门名称或工具标识。
2. Score(基准评分)
Score 适用于带有评价标准的等级打分。开发者需要预先定义有序档位(例如将故障划分为“仅影响外观”、“功能受损但有替代方案”、“关键功能完全不可用”三个等级),而不仅是告诉模型模糊的“打个分”。最终返回的分数通常是小数,因为它是各档位编号按预测概率加权后的数学期望值,并不局限于某个离散的整数档位。
3. Noul(概率判断)
Noul 本质上是带概率输出的布尔判断题。对于“客户是否要求退款”,模型可能直接返回 0.98。数值越接近 1.0 表示断言为真的概率越高,接近 0.0 表示更倾向于“否”,而在 0.5 附近则说明处于模棱两可的不确定区间。由于自身已是直接的概率值,Noul 不再额外返回独立的 confidence 字段。
这三个类型的核心价值在于:让调用方软件在发起请求前就确切掌握返回数据的形状(Data Shape)。后续程序可以直截了当地比较概率、设置阈值、排序或分支跳转,彻底告别了对非结构化文本的脆弱解析与正则匹配。
为什么它能这么快?
Jev 的速度与吞吐优势,并不仅是因为“返回的内容变短了”。
在底层推理机制上,通用大语言模型普遍采用自回归(Autoregressive)机制,必须逐个 Token 串行生成字符,即便输出简单的 JSON 也要耗费多次前向传播。而据 TypeSafe 官方介绍,Jev 放弃了逐 Token 文本生成,转而采用面向结构化决策的并行输出机制。
在单次请求中,开发者可以同时声明多个独立的判断问题(例如同时评估部门分类、退款意图与紧急程度),Jev 能够在单次推理中并行完成评估并返回结果。Vercel 在官方接入 Jev 的说明中,也将这一并行评估能力列为它与传统语言模型的重要区别。
注意事项(并行问题的独立性):多个并行声明的问题是基于同一份输入状态独立评估的。这意味着第二个问题并不会自动感知第一个问题的决策结果。如果你的业务流程中存在严格的因果依赖关系,仍需由外部业务代码来组织阶段性流转。
与传统 LLM 的“结构化输出”有何不同?
这里需要厘清一个常见的认知误区:传统的生成式模型并非只能输出杂乱的自由文本。
现有前沿模型(如 OpenAI GPT-4o、Anthropic Claude)已经支持 Structured Outputs(结构化输出),通过强制约束 JSON Schema 来保证输出符合指定格式。
然而,传统模型的本质依然是在语法掩码约束下逐个 Token 串行生成文本,计算开销与延迟依然受制于自回归机制。同时官方也明确提醒:格式合规(Syntactically Valid)并不等于内容真实正确(Semantically Accurate)。
因此,Jev 的差异化不在于“终于让 AI 学会了返回 JSON”,而是从底层架构彻底剥离了自由文本生成的包袱,用更聚焦的有限答案空间,换取极限的吞吐效率、极低的时延与原生的校准概率。
比“选什么”更重要的,是“不确定时怎么办”
假设系统在两次工单分类判断中,最终都将最高概率给到了“账单部门”,但其详细的概率分布如下:
- 工单 A:账单 98%,技术 1%,销售 1%
- 工单 B:账单 40%,技术 35%,销售 25%
两次判断的最高概率选项虽然相同,但任何健壮的软件系统都绝不应该对它们采取完全一样的处理方式:工单 A 可以直接由自动化流水线秒级派单,而工单 B 显然处于高争议状态,更适合打上待确认标记或转交人工介入。
这就是 Jev 将概率分布与不确定性置于核心地位的原因。
RLCD:面向校准决策的强化学习
传统聊天模型的 RLHF(基于人类反馈的强化学习)更侧重优化回复的顺畅度与人类偏好,这有时容易导致模型在不确定时表现出盲目的过度自信。
针对这一痛点,TypeSafe 采用了专门的训练方法 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。其核心目标不仅是选出高概率答案,更在于让输出的概率分布与真实世界的统计分布相校准(Calibrated)。
所谓校准,可以用一个统计场景来说明:
如果模型对 1000 条客服消息给出的“退款意图”概率均为 80%,那么在事后人工复核中,这 1000 条消息里实际属于退款请求的比例也应该非常接近 80%。
正确理解 Confidence 指标:需要特别注意,Jev 在 Choice 和 Score 中返回的 confidence 并不等同于“这次回答绝对正确的概率”。它是根据返回的概率分布计算出的集中度概括指标,用来反映判断是明确集中还是高度分散。在实际业务落地中,开发者仍需拿真实业务样本进行基准验证,以此确定自动化分流与人工复核的阈值分界线。
对自动化系统来说,真正有用的不是一个永远表现得无比自信的模型,而是一个能够准确量化自身不确定性、方便程序妥善兜底的模型。
“快 193 倍、便宜 444 倍”,应该怎样理解?
在 TypeSafe 官网的宣传中,一组对比数据格外吸睛:在其 System One 工作流基准测试中,Jev 相比对照前沿模型实现了约 193.6 倍的速度提升 和 444.6 倍的成本优势。
这些数字来自特定工作流比较,我们需要结合具体工程条件客观审视:
1. 延迟与响应时间
官方公开介绍给出的端到端响应时间通常在 70 ~ 500 毫秒 之间。官方也坦承,上百倍的极端改善倍数往往处于特定长文本、高推理对比场景的较高端。测试网络节点、输入文本长度、对照模型的推理配置以及是否要求对照模型输出完整 Logprobs 等,都会显著影响实际对比倍率。
2. 准确率评估方法
在 TypeSafe 的工作流评测中,基准参考并非全量来自于独立专家的人工标注,而是采用其他多款前沿强模型的共识汇总。因此,它能够有力展示在特定流程中的相对表现,但不能简单等同于在所有未知垂直场景下都具备普适的准确率。
科技媒体 Every 的一项独立初测提供了直观的侧面参考:在针对 12 段合成文本进行写作问题检查时:
- 耗时对比:Jev 每段的中位耗时为 0.35 秒,对照的 Claude Fable 5.1 在高推理设置下为 8.83 秒,相差约 25 倍;
- 检出效果:在预设的 7 处问题中,Jev 找到了 6 处,对照模型找到了全部 7 处。
这一样本虽小,但清晰体现了实际工程中的核心取舍:是用极低延迟和成本换取高并发吞吐,还是用漫长的深度推理等待换取边际精度的极致提升。
3. 定价与推理成本
在计费方面,截至 2026 年 9 月,官方文档公布的标准费用极低:
- 输入费用:**$0.042 / 百万 Token**
- 输出费用:完全免费
1 | [成本估算示例] |
对于日均数百万次的高频小判断任务,这种成本结构极具吸引力。但在生产环境中,更全面的考量还应包括网络通信、数据清洗、重试逻辑以及异常情况的人工介入成本。
“没有幻觉”,不等于“不会犯错”
这是理解与落地 Jev 时必须守住的一道边界。
TypeSafe 所强调的“类型安全”与“零幻觉”,其严谨含义是:输出被严格限定在预先定义的答案空间与数据结构中。
比如,在候选项仅有 billing、tech 与 sales 时,Jev 在机制上绝不会凭空捏造一个诸如“量子事务部”的不存在字段。
它保证了绝不跳出答题卡,但并不保证每道题都答对。
它依然可能误将技术故障判定为账单问题,也可能低估一张紧急工单的严重程度。
更进一步,在系统工程设计上:即便模型准确识别出“客户希望退款”,程序也绝不能据此直接触发支付网关退款。
后续操作依然必须由严谨的业务规则把关:订单是否存在?交易是否重复?是否在退款时限内?操作人员是否有授权?
一种合理的系统架构设计是:
- 模型负责语义识别:处理非结构化自然语言中的主观性与模糊性;
- 代码负责规则与执行:核验记录、执行状态机、调用业务 API;
- 异常机制负责兜底:低置信度结果自动进入人工复核或交由高推理模型二审。
它适合放在哪里?
Jev 更适合成为现有软件流水线中的一个高频节点,而不是独自包揽全流程任务:
- 智能请求路由(Router):客服系统的工单分派、社区发帖的违规预审、多 Agent 架构中决定下一步调度哪个专用工具或 Subagent。
- Agent 执行控制(Controller):判断当前工具执行结果是“成功”、“需要重试”还是“陷入死循环需人工接入”,驱动决策状态机。
- 内容与合规质检(Evaluator):作为低成本的裁判模型(LLM-as-a-Judge),批量检查生成式模型的输出是否符合既定规范。
相反,如果任务目标是写一封邮件、生成一段业务代码或向用户详细推导判断依据,这些场景依然属于生成式模型的绝对领域。同时,Jev 当前仅接收文本形态的输入(如字符串、JSON 对象或文本数组),无法直接输入图像、音频等多模态数据,多模态内容需先经过转换。
推荐的系统协作范式:
- 传统确定性代码:负责硬规则、权限校验与实际事务执行;
- Jev(决策模型):负责高频、低延迟、强类型化的语义判断与状态分流;
- 生成式 LLM:负责长程推理、内容创作与人机交互;
- 人工专家:负责关键审批与疑难边缘案例兜底。
从聊天窗口,走向软件内部
“Jev” 这个名字取自英国经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)以及著名的杰文斯悖论(Jevons Paradox):
当某种资源的使用效率大幅提升、成本显著下降时,该资源的总消耗量往往不仅不会减少,反而会因为应用边界的指数级扩张而大幅激增。
TypeSafe 借此表达了对 AI 普及路径的深刻预期:当可靠的语义判断变得足够轻巧、响应时间进入几十毫秒量级、调用成本低至几乎可以忽略不计,开发者会毫不犹豫地把它嵌入到成千上万个以往根本不舍得用 AI 的日常代码分支中。
通用对话助手能否让人满意,往往取决于它能否把长篇大论写得生动可信;而软件底层的判断组件,衡量标准则完全不同:延迟是否够低、成本是否可控、接口是否足够强类型安全,以及系统能否在其产生疑虑时平稳降级。
Jev 不需要证明自己“比会聊天的模型更高级”。它只需要在那些数以亿计、候选项明确、却必须读懂人话的后台分支里,证明自己是那个比通用模型更轻巧、更可靠的“语义判断函数”。
它真正具有启发性的地方,正是让 AI 走出人机对话的窗口,静默地沉淀为现代软件系统内部随处可调用的基础设施。


评论